G-VLA
ECCV 2026 · 2026
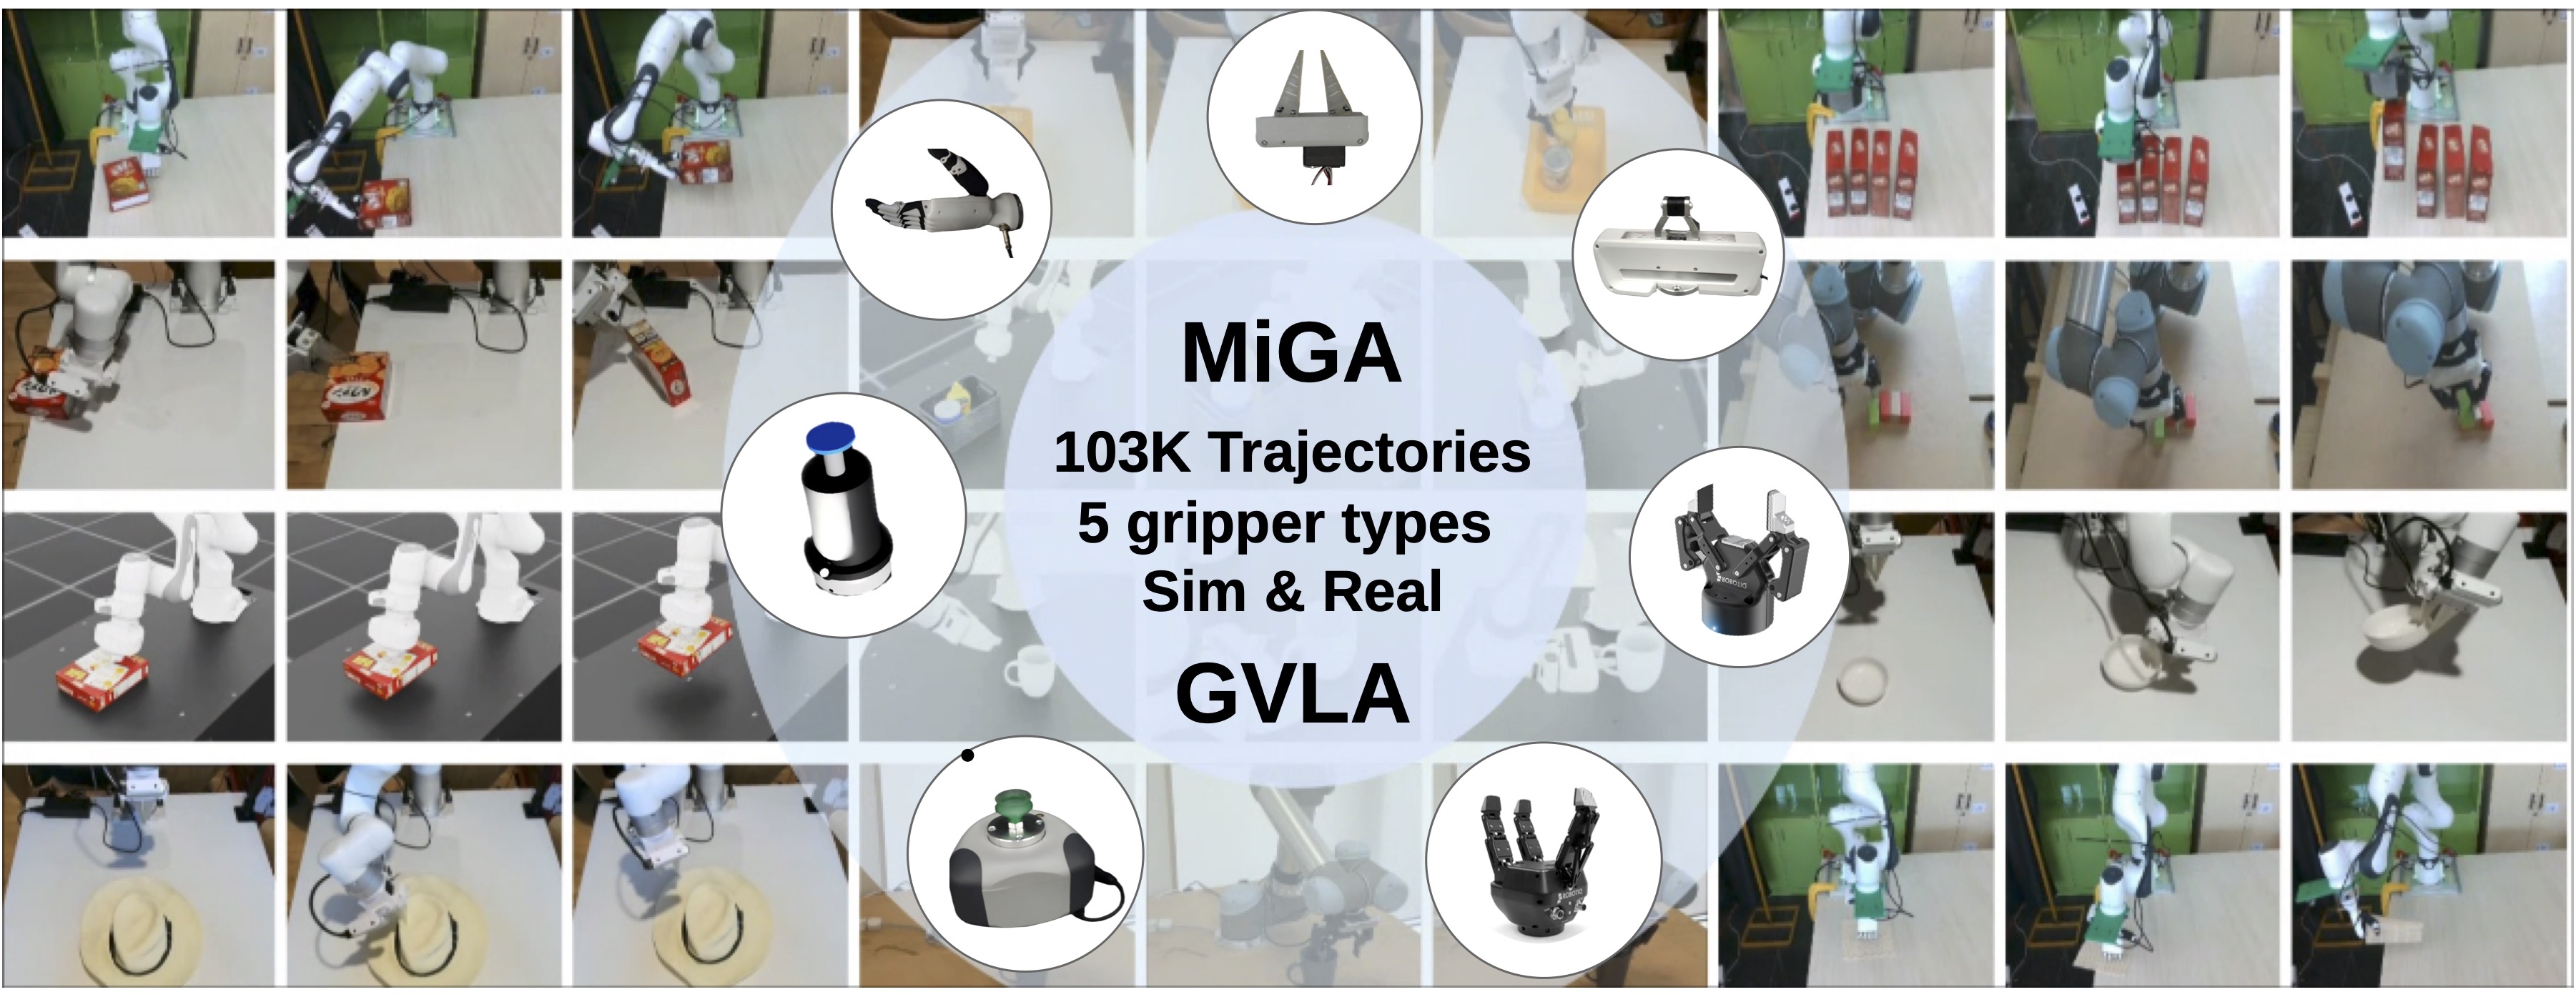
Gripper-aware Vision Language Action Models は、より信頼性が高く転移可能なロボット制御を実現するために、エンドエフェクタ形状を Vision-Language-Action ポリシーへどのように組み込むべきかを検討した研究です。
本研究は、操作・把持タスクにおけるグリッパ条件付き表現に焦点を当て、異なるハードウェア構成間でのポリシーの頑健性向上を目指します。
論文: OpenReview · PDF
関連論文
H. Zhang, Z. Luo, T. Li, K. Nguyen, B. Hela, S. Kumar, N. D. Tran, F. Dai, C. Munasinghe, J. P. Queralta, G. Toffetti, K. Vo, N. Le, R. Prakash, Q. Vuong, T. D. Ta, L. Hu, A. Nguyen, and B. Huang, “Gripper-aware Vision Language Action Models,” European Conference on Computer Vision (ECCV), 2026. OpenReview PDF.